Données publiques
Prix et caractéristiques informés par le catalogue OpenRouter. Les benchmarks publiés par les fournisseurs ou d'autres chercheurs doivent conserver l'attribution, la version et la méthode de la source.
Voir les tarifs publiésÉvaluation technique · RVMR-B01
Consultez les prix publics des modèles et, séparément, les résultats de notre test technique. Les sources, dates et limites de chaque information sont identifiées.
Les prix et caractéristiques des modèles peuvent être consultés dans des sources publiques. Notre test ajoute une mesure sur les tâches synthétiques 24 ; il n'est pas nécessaire de consulter les prix et ne mesure pas les gains de productivité des entreprises.
Prix et caractéristiques informés par le catalogue OpenRouter. Les benchmarks publiés par les fournisseurs ou d'autres chercheurs doivent conserver l'attribution, la version et la méthode de la source.
Voir les tarifs publiésRéponses, délais et coûts rapportés par API sur les appels 288 avec données synthétiques. Les résultats sont limités aux tâches et paramètres enregistrés.
Afficher les résultats des testsLe protocole de production et de révision de contenu est ouvert à l’inscription. Il n'existe toujours pas de résultats publiés sur l'impact sur le travail des entreprises.
Découvrez l'étudeNous commençons par les sources disponibles. Un test spécifique n'est proposé que lorsqu'il y a une question spécifique à laquelle ils ne répondent pas. Avant d'exécuter, nous définissons la question, les critères d'évaluation et le budget.
Consultation. Il s'agit du registre utilisé lors des tests, sans mise à jour automatique.
Prix d'entrée et de sortie par million de tokens en USD, sans conversion de devise. La colonne Itinéraire affiche les prix annoncés du fournisseur demandé lors du test, avec le repli désactivé. Il ne s'agit pas du prix facturé par Rovemark au client. D'autres champs, comme le cache et le tarif par requête, se trouvent dans le fichier consulté ; ils ne sont pas inclus dans ce tableau d’entrées et de sorties.
| Modèle et version | Catalogue : entrée/sortie | Itinéraire demandé : entrée/sortie |
|---|---|---|
DeepSeek: DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash-20260910 | USD 0,0173 / 0,8 | USD 0,09 / 0,18decart/fp4 |
OpenAI: GPT-6 Lunaopenai/gpt-6-luna-20260922 | USD 0,1 / 0,5 | USD 0,1 / 0,5openai |
Anthropic: Claude Haiku 5.5anthropic/claude-haiku-5.5-20261007 | USD 0,1 / 0,5 | USD 0,1 / 0,5google-vertex/global |
Google: Gemini 4 Argongoogle/gemini-4-argon-20261013 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Sonnet 5.5anthropic/claude-sonnet-5.5-20260928 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Opus 5.5anthropic/claude-opus-5.5-20260921 | USD 4 / 20 | USD 4 / 20amazon-bedrock |
La sélection de recherche ne modifie pas les modèles Rovemark ni le tableau de facturation. Le plan fixe le fournisseur et la limite de prix avant l'exécution, avec blocage de la collecte de données dans les préférences de routage.
Chacune des tâches 24 possède une référence vérifiable. L'évaluation compare le JSON reçu avec la réponse attendue, y compris les valeurs manquantes et les refus d'effectuer des actions sans autorisation.
Le coût de toutes les tentatives, y compris les tentatives incorrectes, est divisé par celles approuvées. Sans approbation ou avec usage.cost manquant lors de toute tentative, nous ne calculons pas le coût déclaré par approbation.
Nous publions la médiane et le centile 95 du temps observé par le client, ainsi que les erreurs et les réponses invalides. Le temps inclut le réseau et dépend du fournisseur et de la date.
Mêmes tâches synthétiques 24, deux répétitions par modèle. Les tarifs décrivent cet ensemble, en portugais, sous les paramètres et les prestataires enregistrés. L'approbation nécessite des valeurs et un format JSON corrects ; il ne s’agit pas d’un taux d’exactitude factuel isolé. Le test ne mesure pas la productivité de l’entreprise ni la pleine capacité de chaque modèle.
Coûts rapportés par les réponses API, avec vérification agrégée du nombre d'appels sur le panel. Nous ne présentons pas les frais individuels comme rapprochés. Aucune nouvelle déduction n’a été faite pour étudier la différence.
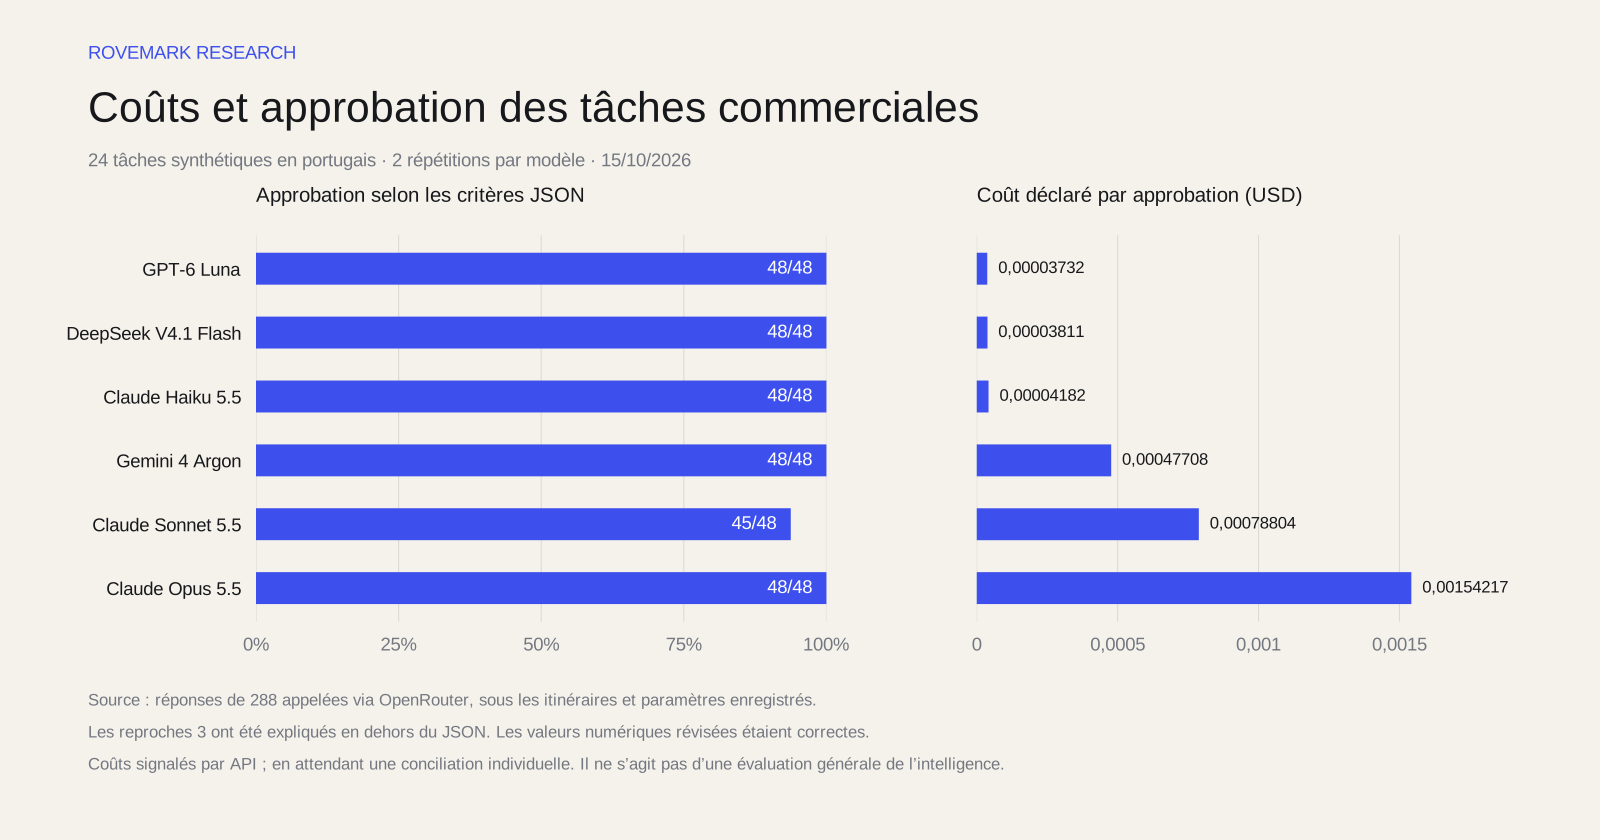
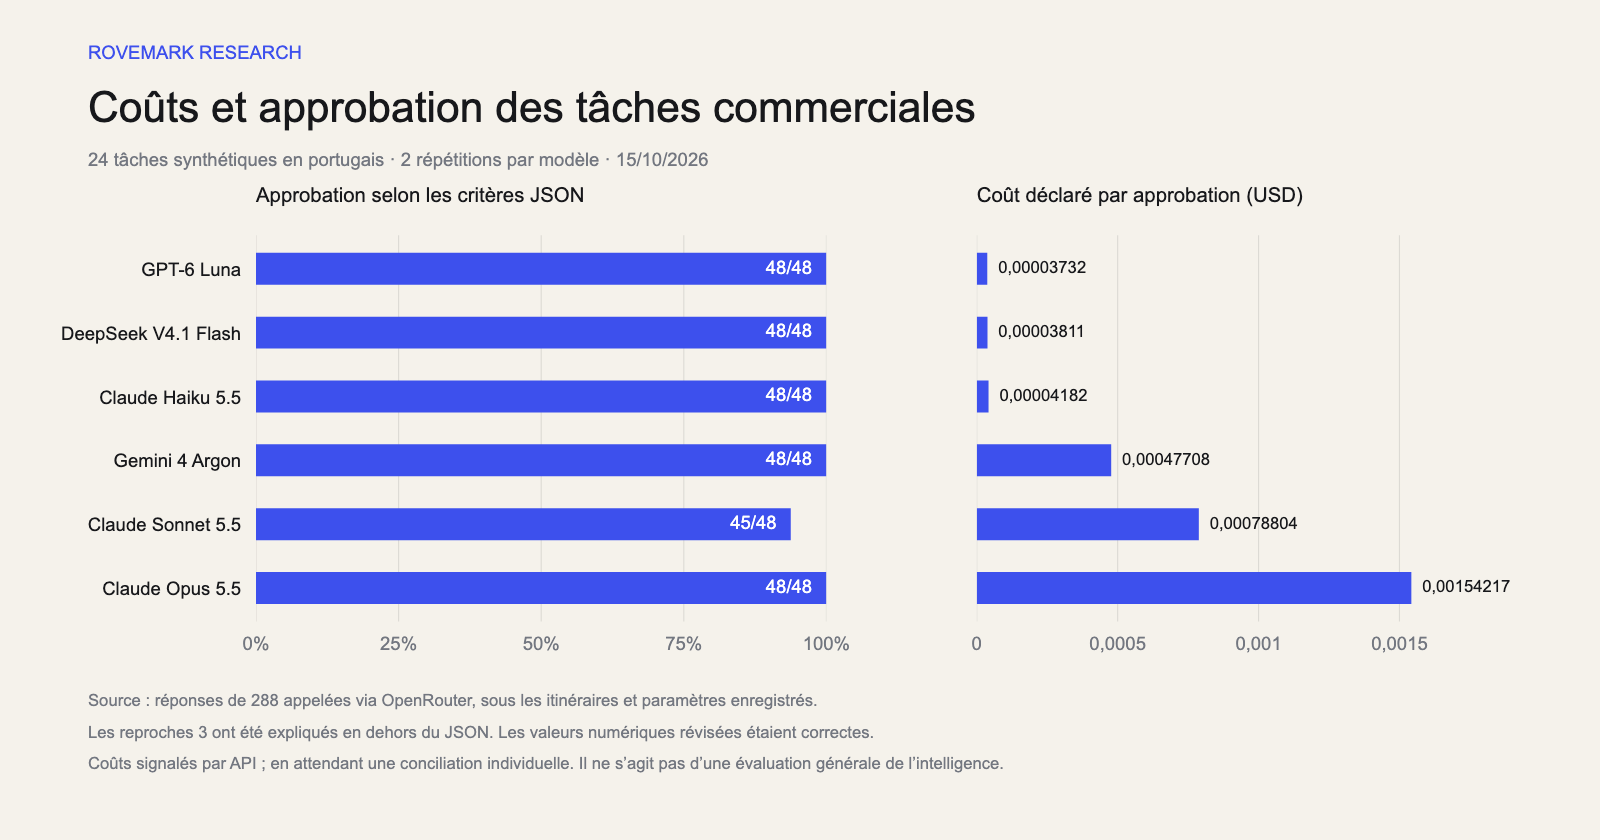
GPT-6 Luna présentait le coût par approbation le plus bas dans cet échantillon, très proche de DeepSeek V4.1 Flash. Haiku 5.5 avait le temps médian le plus bas. Cinq modèles répondaient aux critères des essais 48 des essais 48. Les trois désapprobations de Sonnet 5.5 étaient dues à une explication extérieure à JSON ; les valeurs numériques révisées étaient correctes.
Sélectionnez une barre pour inspecter les réponses de ce modèle ci-dessous. En termes d'indicateurs de temps et de coût, les valeurs inférieures sont meilleures. Le temps comprend les essais de réseau et d'erreurs ; un échec rapide ne démontre pas de meilleures performances.
| Modèle | Approbations | Erreurs API | Coût déclaré | Coût déclaré par approbation | Médiane / p95 |
|---|---|---|---|---|---|
| OpenAI: GPT-6 LunaItinéraire demandé : openai | 48/48100% | 0 | USD 0,0017915 | USD 0,00003732 | 2,01s / 2,93s |
| DeepSeek: DeepSeek V4.1 FlashItinéraire demandé : decart/fp4 | 48/48100% | 0 | USD 0,00182934 | USD 0,00003811 | 2,93s / 8,99s |
| Anthropic: Claude Haiku 5.5Itinéraire demandé : google-vertex/global | 48/48100% | 0 | USD 0,0020076 | USD 0,00004182 | 1,1s / 2,09s |
| Google: Gemini 4 ArgonItinéraire demandé : google-vertex/global | 48/48100% | 0 | USD 0,0229 | USD 0,00047708 | 2,6s / 3,88s |
| Anthropic: Claude Sonnet 5.5Itinéraire demandé : google-vertex/global | 45/4893,8% | 0 | USD 0,035462 | USD 0,00078804 | 1,31s / 2,64s |
| Anthropic: Claude Opus 5.5Itinéraire demandé : amazon-bedrock | 48/48100% | 0 | USD 0,074024 | USD 0,00154217 | 1,62s / 4,3s |
Valeurs usage.cost signalées dans les réponses OpenRouter, dans USD. Le rapprochement externe individuel reste en attente et n’a pas été remplacé par une estimation de la dette. Il s'agit notamment des tentatives incorrectes et infructueuses lors de la facturation. Ils n'incluent pas l'achat de crédits, les taxes, les taux de change, les infrastructures ou les coûts humains de révision. Lorsque usage.cost est manquant lors d'une tentative, les totaux rapportés deviennent indisponibles. Ceci est distinct du rapprochement externe de la déclaration, signalé ci-dessus.
L'inspection utilise le modèle et la sélection de tâches ci-dessous, indépendamment du découpage du graphique.
Les demandes et réponses originales ci-dessous sont en portugais, la langue d'exécution. La traduction de l'interface ne modifie pas les enregistrements de test.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.
{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,66s température 0
Fournisseur informé : Decart · itinéraire demandé : decart/fp4
{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,97s température 0
Fournisseur informé : Decart · itinéraire demandé : decart/fp4
3 de 288 les tentatives ne répondaient pas au critère. Les échecs de transport, les problèmes de format et les divergences de contenu sont identifiés séparément lorsqu'ils sont notés. Les trois échecs de cette exécution étaient du texte supplémentaire en dehors de JSON : un examen manuel ultérieur a confirmé que les valeurs numériques dans ces cas correspondaient à la référence. Cet examen n’a pas modifié les scores des critères d’origine.
Tous les cas utilisent des informations synthétiques. Il existe quatre groupes : extraction, utilisation des sources, calculs commerciaux et suivi des instructions.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}Le plan définissait deux répétitions par tâche et par modèle. La répétition des mêmes cas ne crée pas de tâches indépendantes 48. La commande a été mélangée avec des semences enregistrées, avec une limite de sortie, un prix et une dépense totale. Les appels payants envoyés n’étaient pas automatiquement réessayés.
La réussite exacte mesure un ensemble restreint de tâches avec des réponses fermées. Il ne mesure pas la qualité littéraire, la pleine intelligence d’un modèle ou l’effet de l’IA sur la productivité d’une entreprise. Nous n'utilisons pas un autre modèle comme juge et n'activons pas le mode JSON ou le schéma de réponse du fournisseur. Nous évaluons le respect du format par instruction dans l'invite. L'utilisation d'une sortie structurée peut modifier ce comportement et n'a pas été testée ici. L'ordre des clés et toute éventuelle barrière de code JSON sont ignorés ; les valeurs et le jeu de clés doivent correspondre à la référence.
Les enregistrements identifient le modèle, l'itinéraire demandé, le fournisseur informé, les paramètres, la date et la consommation réelle. Quatre des six itinéraires ne proposent pas de réglage de la température : le paramètre a été omis dans ces cas. Dans les deux autres, nous utilisons une température nulle. L’effort de raisonnement et le comportement standard peuvent différer d’une famille à l’autre ; nous ne supposons pas de paramètres équivalents. Le plafond de sortie était de jetons 700 dans toutes les tentatives. Les taux d’achat de crédit, les taxes, les taux de change et les infrastructures ne font pas partie du coût d’inférence et doivent être pris en compte dans les décisions commerciales.
Rovemark développe des produits d'IA et a un intérêt commercial dans cette technologie. Le protocole, les enregistrements synthétiques, le code et les fichiers d'exécution exacts sont disponibles pour un examen indépendant. Les dossiers n'ont pas été modifiés après le début des appels.
De nombreux fournisseurs publient les prix, les caractéristiques et les avis de leurs propres modèles. Nous pouvons recueillir ces informations avec la source et la date, sans passer d'appels payants. La liste de prix sur cette page provient du catalogue public OpenRouter. Les résultats des appels 288 proviennent du test technique du Rovemark et sont présentés séparément. Les résultats de tiers doivent être attribués aux auteurs, sans être présentés comme notre validation.
Lorsqu'une décision concrète dépend de quelque chose auquel les sources disponibles ne répondent pas, comme le respect d'un format dans nos instructions ou le coût d'un flux spécifique. Nous définissons d’abord la question et vérifions les études existantes. Si les preuves font encore défaut, nous proposons le plus petit test approprié, avec des critères et un budget définis avant exécution. Un test avec des tâches synthétiques ne remplace pas la recherche sur la productivité en entreprise.
Il compare six modèles dans cet ensemble de tâches 24 en portugais, sous les itinéraires et configurations enregistrés. Un taux plus élevé ne prouve pas ici une supériorité globale. Nous ne testons pas toutes les écritures, pensées ouvertes ou flux de travail possibles.
Le coût observé permet de choisir des candidats pour des tâches similaires. La suite ne teste pas les appels d'outils réels, les documents longs, les images, les données privées ou tous les contrôles de sécurité d'un produit. Un changement de modèle de production nécessite une évaluation du flux dans lequel il sera utilisé.
Le prix par jeton ne vous indique pas combien de jetons le modèle consommera ni combien de réponses seront utilisables. Nous divisons le coût de toutes les tentatives par le nombre de celles qui ont satisfait au critère. Les mauvaises réponses coûtent également cher et sont incluses dans le total.
Ce sont des tâches 24, chacune répétée deux fois. Les répétitions aident à observer la variation, mais n'étendent pas la diversité aux problèmes indépendants 48. Les résultats sont descriptifs ; Nous ne publions pas d’intervalles de confiance ni de signification statistique pour une population de tâches.
Lors de l'interrogation des points de terminaison, quatre des six routes n'ont pas déclaré la prise en charge du paramètre temperature. Dans ceux-ci, nous omettons l'ajustement et enregistrons le défaut du fournisseur. Dans les deux autres, nous utilisons zéro. La limite de sortie était de jetons 700 pour tout le monde. La température et l'effort de raisonnement des différentes familles ne sont pas supposés être équivalents.
La section d'inspection affiche la demande du modèle, la référence et deux réponses. L'approbation nécessite les mêmes valeurs et clés dans l'objet JSON ; l'ordre des clés et toute éventuelle barrière de code JSON sont ignorés. Les données complètes préservent les réponses ayant échoué et les échecs API.
Les fichiers d'exécution exacts, le protocole, les réponses de référence, les graines de tri et les résultats sont disponibles en téléchargement. Une nouvelle course nécessite ses propres références et son propre budget. La disponibilité, les tarifs et le comportement des fournisseurs peuvent changer, même en conservant l'identifiant du modèle.
Le coût d’inférence n’est qu’une partie de l’opération. Les frais, taxes, taux de change, infrastructures et examen humain sont exclus de cet indicateur. Le test ne mesure pas la productivité de l’entreprise. Le protocole séparé de production et d’examen avec les entreprises se poursuit sans que ses propres résultats soient publiés.