Dati pubblici
Prezzi e caratteristiche informati dal catalogo OpenRouter. I benchmark rilasciati da fornitori o altri ricercatori devono mantenere l'attribuzione, la versione e il metodo della fonte.
Vedi i prezzi pubblicatiValutazione tecnica · RVMR-B01
Consulta i prezzi al pubblico dei modelli e, separatamente, i risultati dei nostri test tecnici. Sono individuate le fonti, le date ed i limiti di ciascuna informazione.
I prezzi e le caratteristiche dei modelli possono essere consultati in fonti pubbliche. Il nostro test aggiunge una misurazione sui compiti sintetici 24; non è necessario consultare i prezzi e non misura gli incrementi di produttività aziendale.
Prezzi e caratteristiche informati dal catalogo OpenRouter. I benchmark rilasciati da fornitori o altri ricercatori devono mantenere l'attribuzione, la versione e il metodo della fonte.
Vedi i prezzi pubblicatiRisposte, tempi e costi riportati da API su chiamate 288 con dati sintetici. I risultati sono limitati alle attività e alle impostazioni registrate.
Visualizza i risultati dei testÈ aperta la registrazione al protocollo di produzione e revisione dei contenuti. Non sono ancora stati pubblicati risultati sugli effetti sul lavoro delle aziende.
Scopri lo studioIniziamo dalle fonti disponibili. Un test specifico viene proposto solo quando c'è una domanda specifica a cui non si risponde. Prima di procedere definiamo la domanda, i criteri di valutazione e il budget.
Consultazione. Questo è il registro utilizzato nei test, senza aggiornamento automatico.
Prezzi di entrata e di uscita per milione di token in USD, senza conversione di valuta. La colonna del percorso mostra i prezzi pubblicizzati del fornitore richiesto nel test, con fallback disabilitato. Non è il prezzo addebitato da Rovemark al cliente. Altri campi, come cache e addebito per richiesta, si trovano nel file consultato; non sono inclusi in questa tabella di input e output.
| Modello e versione | Catalogo: ingresso/uscita | Percorso richiesto: entrata/uscita |
|---|---|---|
DeepSeek: DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash-20260910 | USD 0,0173 / 0,8 | USD 0,09 / 0,18decart/fp4 |
OpenAI: GPT-6 Lunaopenai/gpt-6-luna-20260922 | USD 0,1 / 0,5 | USD 0,1 / 0,5openai |
Anthropic: Claude Haiku 5.5anthropic/claude-haiku-5.5-20261007 | USD 0,1 / 0,5 | USD 0,1 / 0,5google-vertex/global |
Google: Gemini 4 Argongoogle/gemini-4-argon-20261013 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Sonnet 5.5anthropic/claude-sonnet-5.5-20260928 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Opus 5.5anthropic/claude-opus-5.5-20260921 | USD 4 / 20 | USD 4 / 20amazon-bedrock |
La selezione della ricerca non modifica i modelli Rovemark o la tabella di fatturazione. Il piano fissa il fornitore e il limite di prezzo prima dell'esecuzione, con il blocco della raccolta dei dati nelle preferenze di instradamento.
Ciascuna delle attività 24 ha un riferimento verificabile. La valutazione confronta il JSON ricevuto con la risposta attesa, compresi i valori mancanti e i rifiuti di eseguire azioni senza autorizzazione.
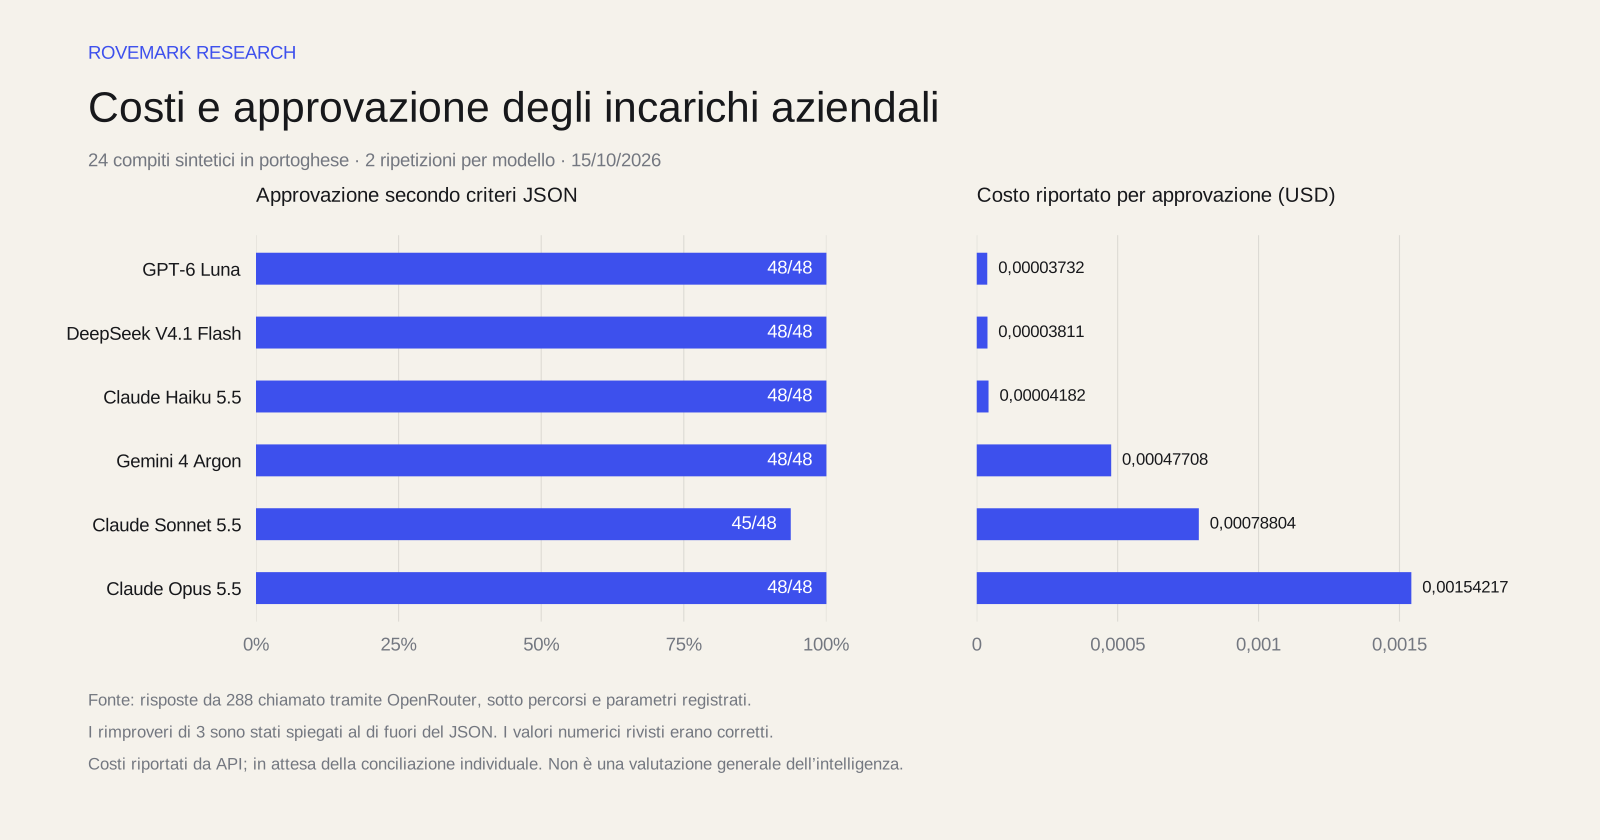
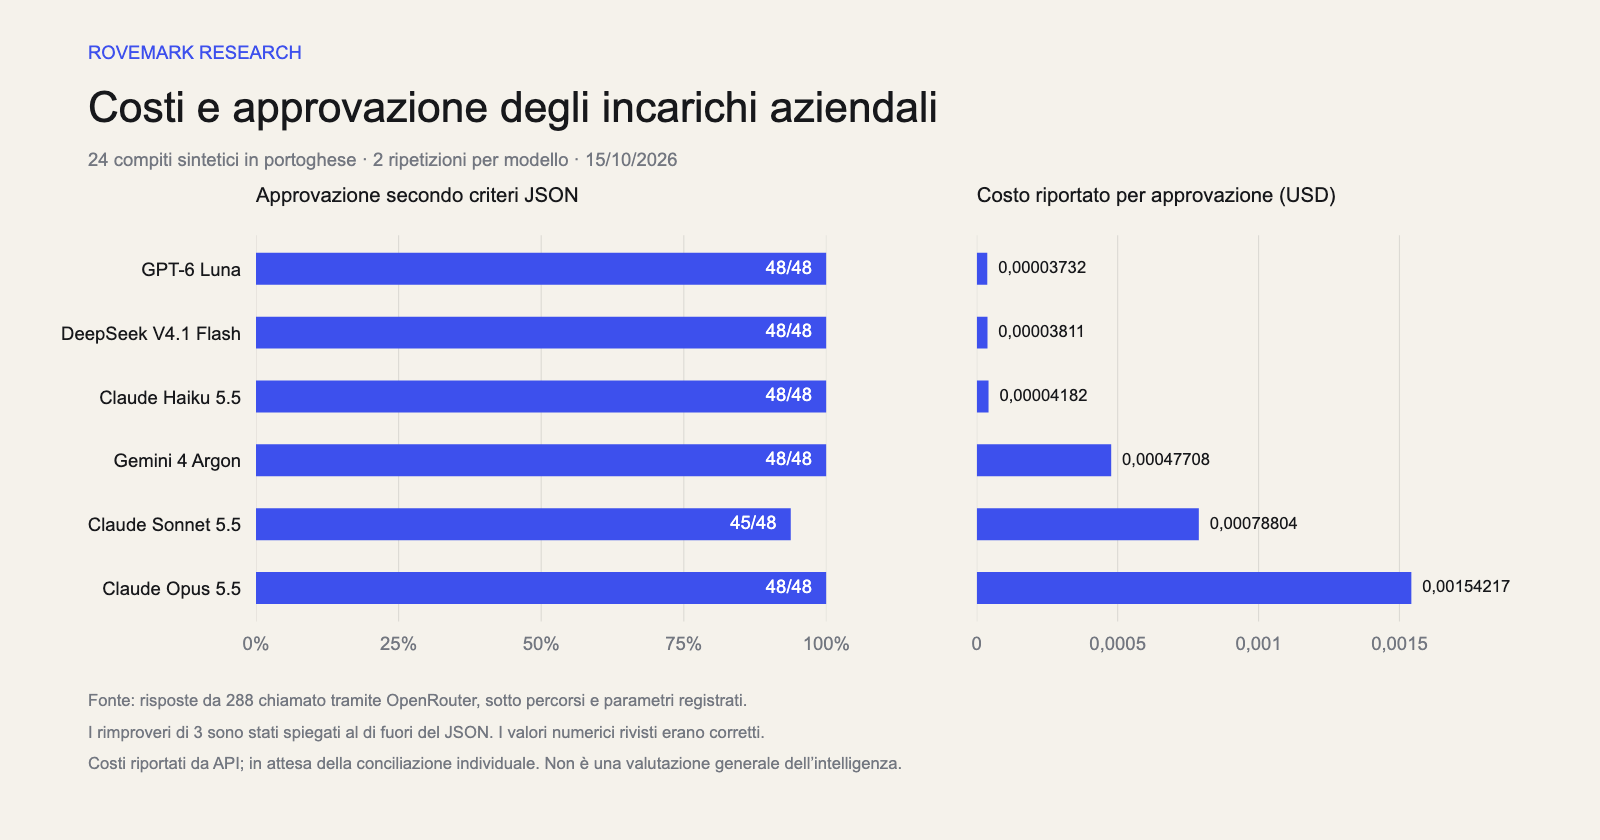
Il costo di tutti i tentativi, compresi quelli errati, viene diviso per quelli approvati. Senza approvazione o con usage.cost mancante in qualsiasi tentativo, non calcoliamo il costo riportato per approvazione.
Pubblichiamo la mediana e il percentile 95 del tempo osservato dal cliente, nonché gli errori e le risposte non valide. L'ora include la rete e dipende dal provider e dalla data.
Stessi compiti sintetici 24, due ripetizioni per modello. Le tariffe descrivono questo insieme, in portoghese, secondo i parametri e i fornitori registrati. L'approvazione richiede valori e formato JSON corretti; non si tratta di un tasso di accuratezza fattuale isolato. Il test non misura la produttività aziendale o la piena capacità di ciascun modello.
Costi riportati dalle risposte API, con verifica aggregata del numero di chiamate sul pannello. Non presentiamo l'addebito individuale come riconciliato. Non sono state fatte nuove inferenze per indagare la differenza.
GPT-6 Luna ha registrato il costo per approvazione più basso riportato in questo campione, molto vicino a DeepSeek V4.1 Flash. Haiku 5.5 ha avuto il tempo medio più basso. Cinque modelli soddisfacevano il criterio 48 degli studi 48. Le tre disapprovazioni di Sonnet 5.5 erano dovute a una spiegazione esterna a JSON; i valori numerici rivisti erano corretti.
Seleziona una barra per esaminare le risposte di quel modello di seguito. Negli indicatori di tempo e costo, i valori più bassi sono migliori. Il tempo include prove di rete e di errore; un fallimento rapido non dimostra prestazioni migliori.
| Modello | Approvazioni | Errori API | Costo riportato | Costo segnalato previa approvazione | Mediana/p95 |
|---|---|---|---|---|---|
| OpenAI: GPT-6 LunaItinerario richiesto: openai | 48/48100% | 0 | USD 0,0017915 | USD 0,00003732 | 2,01s / 2,93s |
| DeepSeek: DeepSeek V4.1 FlashItinerario richiesto: decart/fp4 | 48/48100% | 0 | USD 0,00182934 | USD 0,00003811 | 2,93s / 8,99s |
| Anthropic: Claude Haiku 5.5Itinerario richiesto: google-vertex/global | 48/48100% | 0 | USD 0,0020076 | USD 0,00004182 | 1,1s / 2,09s |
| Google: Gemini 4 ArgonItinerario richiesto: google-vertex/global | 48/48100% | 0 | USD 0,0229 | USD 0,00047708 | 2,6s / 3,88s |
| Anthropic: Claude Sonnet 5.5Itinerario richiesto: google-vertex/global | 45/4893,8% | 0 | USD 0,035462 | USD 0,00078804 | 1,31s / 2,64s |
| Anthropic: Claude Opus 5.5Itinerario richiesto: amazon-bedrock | 48/48100% | 0 | USD 0,074024 | USD 0,00154217 | 1,62s / 4,3s |
Valori usage.cost riportati nelle risposte OpenRouter, in USD. La riconciliazione esterna individuale resta in sospeso e non è stata sostituita da una stima del debito. Questi includono tentativi errati e falliti al momento dell'addebito. Non includono l'acquisto di crediti, tasse, tassi di cambio, infrastrutture o costi umani di revisione. Quando usage.cost manca in qualsiasi tentativo, i totali riportati diventano non disponibili. Questo è separato dalla riconciliazione esterna della dichiarazione, contrassegnata sopra.
L'ispezione utilizza la selezione del modello e dell'attività riportata di seguito, indipendentemente dal ritaglio del grafico.
Le richieste originali e le risposte riportate di seguito sono in portoghese, la lingua di esecuzione. La traduzione dell'interfaccia non modifica i record di test.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.
{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,66s temperatura 0
Fornitore informato: Decart · percorso richiesto: decart/fp4
{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,97s temperatura 0
Fornitore informato: Decart · percorso richiesto: decart/fp4
3 di 288 i tentativi non hanno soddisfatto il criterio. Gli errori di trasporto, i problemi di formato e le discrepanze di contenuto vengono identificati separatamente quando segnalati. I tre fallimenti di questa esecuzione erano testo aggiuntivo al di fuori di JSON: una successiva revisione manuale ha confermato che i valori numerici in questi casi corrispondevano al riferimento. Questa revisione non ha modificato i punteggi dei criteri originali.
Tutti i casi utilizzano informazioni sintetiche. Ci sono quattro gruppi: estrazione, utilizzo delle fonti, calcoli aziendali e seguenti istruzioni.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}Il piano prevedeva due ripetizioni per attività e modello. La ripetizione degli stessi casi non crea attività 48 indipendenti. L'ordine è stato mescolato con seed registrato, con limite di uscita, prezzo e spesa totale. Le chiamate a pagamento inviate non sono state ritentate automaticamente.
Il passaggio esatto misura un insieme ristretto di attività con risposte chiuse. Non misura la qualità letteraria, la piena intelligenza di un modello o l’effetto dell’intelligenza artificiale sulla produttività di un’azienda. Non utilizziamo un altro modello come giudice né attiviamo la modalità JSON o lo schema di risposta del fornitore. Valutiamo la conformità al formato per istruzione nel prompt. L'utilizzo dell'output strutturato può modificare questo comportamento e non è stato testato qui. L'ordine delle chiavi e l'eventuale recinzione del codice JSON vengono ignorati; i valori e il set di chiavi devono corrispondere al riferimento.
Le registrazioni identificano modello, percorso richiesto, fornitore informato, parametri, data e consumo effettivo. Quattro dei sei percorsi non offrono la regolazione della temperatura: in questi casi il parametro è stato omesso. Negli altri due utilizziamo la temperatura zero. Lo sforzo di ragionamento e il comportamento standard possono differire tra le famiglie; non assumiamo parametri equivalenti. Il limite massimo di output era di token 700 in tutti i tentativi. I tassi di acquisto del credito, le tasse, i tassi di cambio e le infrastrutture non rientrano nel costo di inferenza e devono essere considerati nelle decisioni commerciali.
Rovemark sviluppa prodotti di intelligenza artificiale e ha un interesse commerciale in questa tecnologia. Il protocollo, i record sintetici, il codice e i file esatti della corsa sono disponibili per una revisione indipendente. I casi non sono stati modificati dopo l'inizio delle chiamate.
Molti fornitori pubblicano prezzi, caratteristiche e recensioni dei propri modelli. Possiamo raccogliere queste informazioni con fonte e data, senza effettuare chiamate a pagamento. Il listino prezzi presente in questa pagina proviene dal catalogo pubblico OpenRouter. I risultati dei bandi 288 provengono dal test tecnico del Rovemark e sono presentati separatamente. I risultati di terze parti devono essere attribuiti agli autori, senza essere presentati come nostra convalida.
Quando una decisione concreta dipende da qualcosa a cui le fonti disponibili non rispondono, come il rispetto di un formato nelle nostre istruzioni o il costo di un flusso specifico. Per prima cosa definiamo la domanda e controlliamo gli studi esistenti. Se mancano ancora le prove, proponiamo il test più piccolo e appropriato, con criteri e budget definiti prima dell'esecuzione. Un test con compiti sintetici non sostituisce la ricerca sulla produttività nelle aziende.
Confronta sei modelli in questa serie di attività 24 in portoghese, in base ai percorsi e alle configurazioni registrate. Un tasso più elevato in questo caso non dimostra una superiorità complessiva. Non testiamo tutta la scrittura possibile, il pensiero aperto o i flussi di lavoro.
Il costo osservato aiuta a scegliere i candidati per compiti simili. La suite non testa le chiamate effettive degli strumenti, i documenti lunghi, le immagini, i dati privati o tutti i controlli di sicurezza di un prodotto. Un cambiamento del modello nella produzione necessita di una valutazione del flusso in cui verrà utilizzato.
Il prezzo per token non indica quanti token consumerà il modello o quante risposte saranno utilizzabili. Dividiamo la spesa di tutti i tentativi per il numero di quelli che hanno superato il criterio. Anche le risposte sbagliate costano e sono incluse nel totale.
Queste sono attività 24, ciascuna ripetuta due volte. Le ripetizioni aiutano a osservare la variazione, ma non espandono la diversità a problemi 48 indipendenti. I risultati sono descrittivi; Non pubblichiamo intervalli di confidenza o significatività statistica per una popolazione di compiti.
Durante l'interrogazione degli endpoint, quattro dei sei percorsi non hanno dichiarato il supporto per il parametro temperature. In essi omettiamo l'adeguamento e registriamo l'impostazione predefinita del fornitore. Negli altri due usiamo zero. Il limite di uscita era costituito dai token 700 per tutti. Non si presume che la temperatura e lo sforzo di ragionamento di famiglie diverse siano equivalenti.
La sezione di ispezione mostra la richiesta del modello, il riferimento e due risposte. L'approvazione richiede gli stessi valori e chiavi nell'oggetto JSON; l'ordine delle chiavi e l'eventuale recinzione del codice JSON vengono ignorati. I dati completi conservano le risposte non riuscite e gli errori API.
I file esatti della corsa, il protocollo, le risposte di riferimento, il seme di ordinamento e i risultati sono disponibili per il download. Una nuova corsa richiede credenziali e budget propri. La disponibilità, i prezzi e il comportamento del fornitore possono cambiare, anche mantenendo l'identificatore del modello.
Il costo dell’inferenza è solo una parte dell’operazione. Tasse, tasse, tassi di cambio, infrastrutture e revisione umana sono esclusi da questo indicatore. Il test non misura la produttività aziendale. Il protocollo separato di produzione e revisione con le aziende continua senza la pubblicazione dei propri risultati.