Dados públicos
Preços e características informados pelo catálogo do OpenRouter. Benchmarks divulgados por fornecedores ou outros pesquisadores devem manter a atribuição, a versão e o método da fonte.
Ver preços publicadosAvaliação técnica · RVMR-B01
Consulte os preços públicos dos modelos e, separadamente, os resultados do nosso teste técnico. As fontes, as datas e os limites de cada informação estão identificados.
Os preços e as características dos modelos podem ser consultados nas fontes públicas. O nosso teste acrescenta uma medição em 24 tarefas sintéticas; ele não é necessário para consultar preços e não mede ganhos de produtividade de empresas.
Preços e características informados pelo catálogo do OpenRouter. Benchmarks divulgados por fornecedores ou outros pesquisadores devem manter a atribuição, a versão e o método da fonte.
Ver preços publicadosRespostas, tempo e custos informados pela API em 288 chamadas com dados sintéticos. Os resultados se limitam às tarefas e configurações registradas.
Ver resultados do testeO protocolo de produção e revisão de conteúdo está com inscrições abertas. Ainda não há resultados próprios publicados sobre o efeito no trabalho das empresas.
Conhecer o estudoComeçamos pelas fontes disponíveis. Um teste próprio só é proposto quando há uma dúvida específica que elas não respondem. Antes de executar, definimos a pergunta, os critérios de avaliação e o orçamento.
Consulta de. Este é o registro usado no teste, sem atualização automática.
Preços de entrada e saída por milhão de tokens em USD, sem conversão cambial. A coluna de rota mostra os preços anunciados do provedor solicitado no teste, com fallback desativado. Não é o preço cobrado pela Rovemark ao cliente. Outros campos, como cache e cobrança por requisição, estão no arquivo consultado; eles não estão incluídos nesta tabela de entrada e saída.
| Modelo e versão | Catálogo: entrada / saída | Rota solicitada: entrada / saída |
|---|---|---|
DeepSeek: DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash-20260910 | USD 0,0173 / 0,8 | USD 0,09 / 0,18decart/fp4 |
OpenAI: GPT-6 Lunaopenai/gpt-6-luna-20260922 | USD 0,1 / 0,5 | USD 0,1 / 0,5openai |
Anthropic: Claude Haiku 5.5anthropic/claude-haiku-5.5-20261007 | USD 0,1 / 0,5 | USD 0,1 / 0,5google-vertex/global |
Google: Gemini 4 Argongoogle/gemini-4-argon-20261013 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Sonnet 5.5anthropic/claude-sonnet-5.5-20260928 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Opus 5.5anthropic/claude-opus-5.5-20260921 | USD 4 / 20 | USD 4 / 20amazon-bedrock |
A seleção de pesquisa não altera os modelos nem a tabela de cobrança da Rovemark. O plano fixou provedor e limite de preço antes da execução, com bloqueio de coleta de dados nas preferências de roteamento.
Cada uma das 24 tarefas tem uma referência verificável. A avaliação compara o JSON recebido com a resposta esperada, incluindo valores ausentes e recusas de executar ações sem autorização.
O custo de todas as tentativas, inclusive as incorretas, é dividido pelas aprovadas. Sem aprovação ou com usage.cost ausente em alguma tentativa, não calculamos o custo informado por aprovação.
Publicamos mediana e percentil 95 do tempo observado pelo cliente, além de erros e respostas inválidas. O tempo inclui a rede e depende do provedor e da data.
Mesmas 24 tarefas sintéticas, duas repetições por modelo. As taxas descrevem este conjunto, em português, sob os parâmetros e provedores registrados. A aprovação exige valores e formato JSON corretos; não é uma taxa isolada de acerto factual. O teste não mede produtividade de empresas nem toda a capacidade de cada modelo.
Custos informados pelas respostas da API, com conferência agregada do número de chamadas no painel. Não apresentamos a cobrança individual como conciliada. Não foram realizadas novas inferências para investigar a diferença.
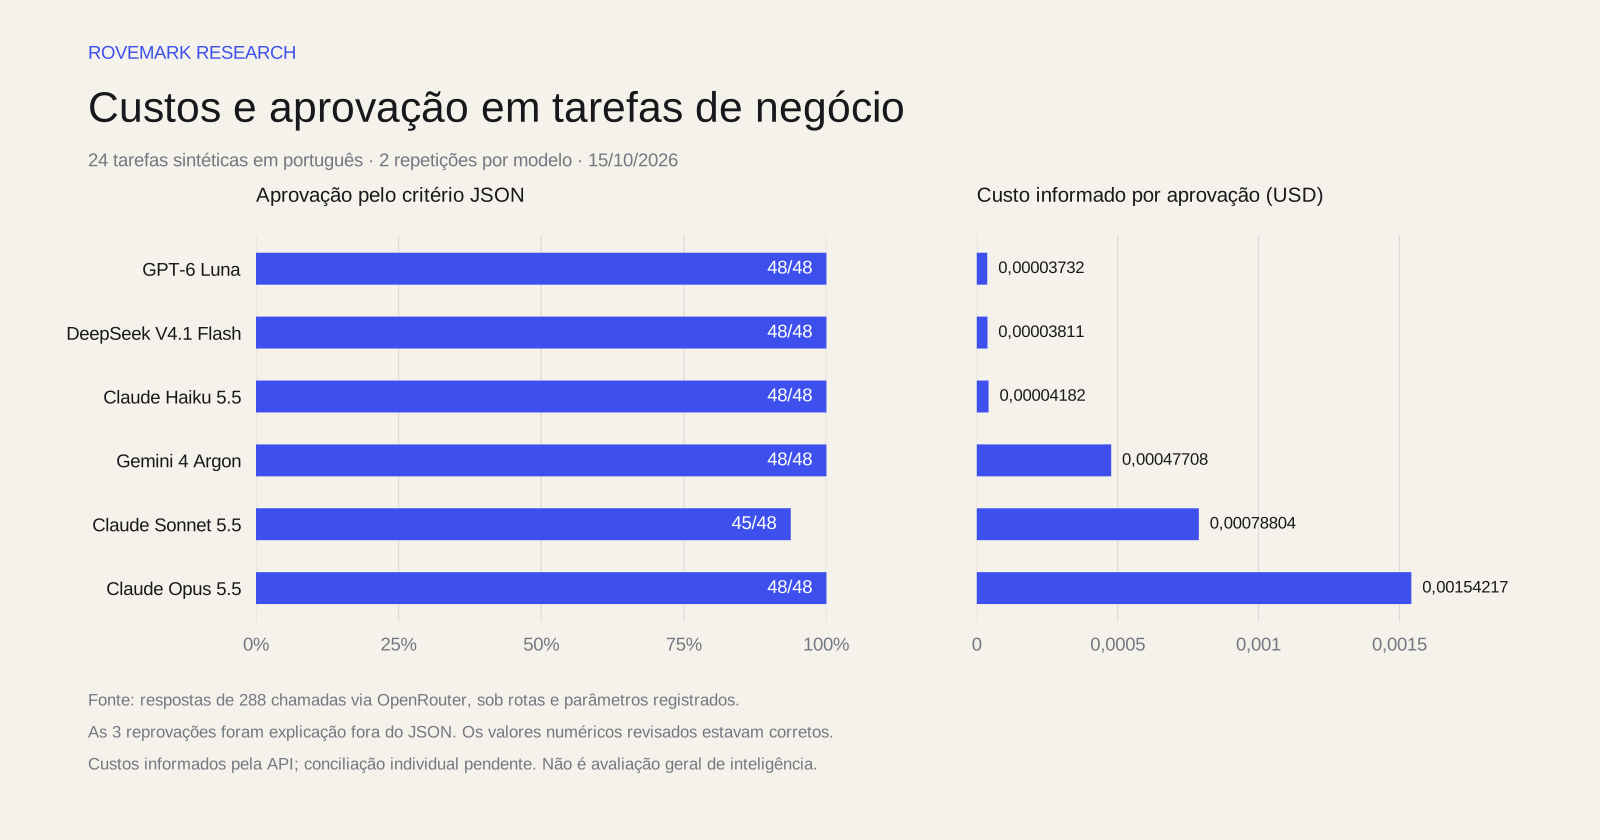
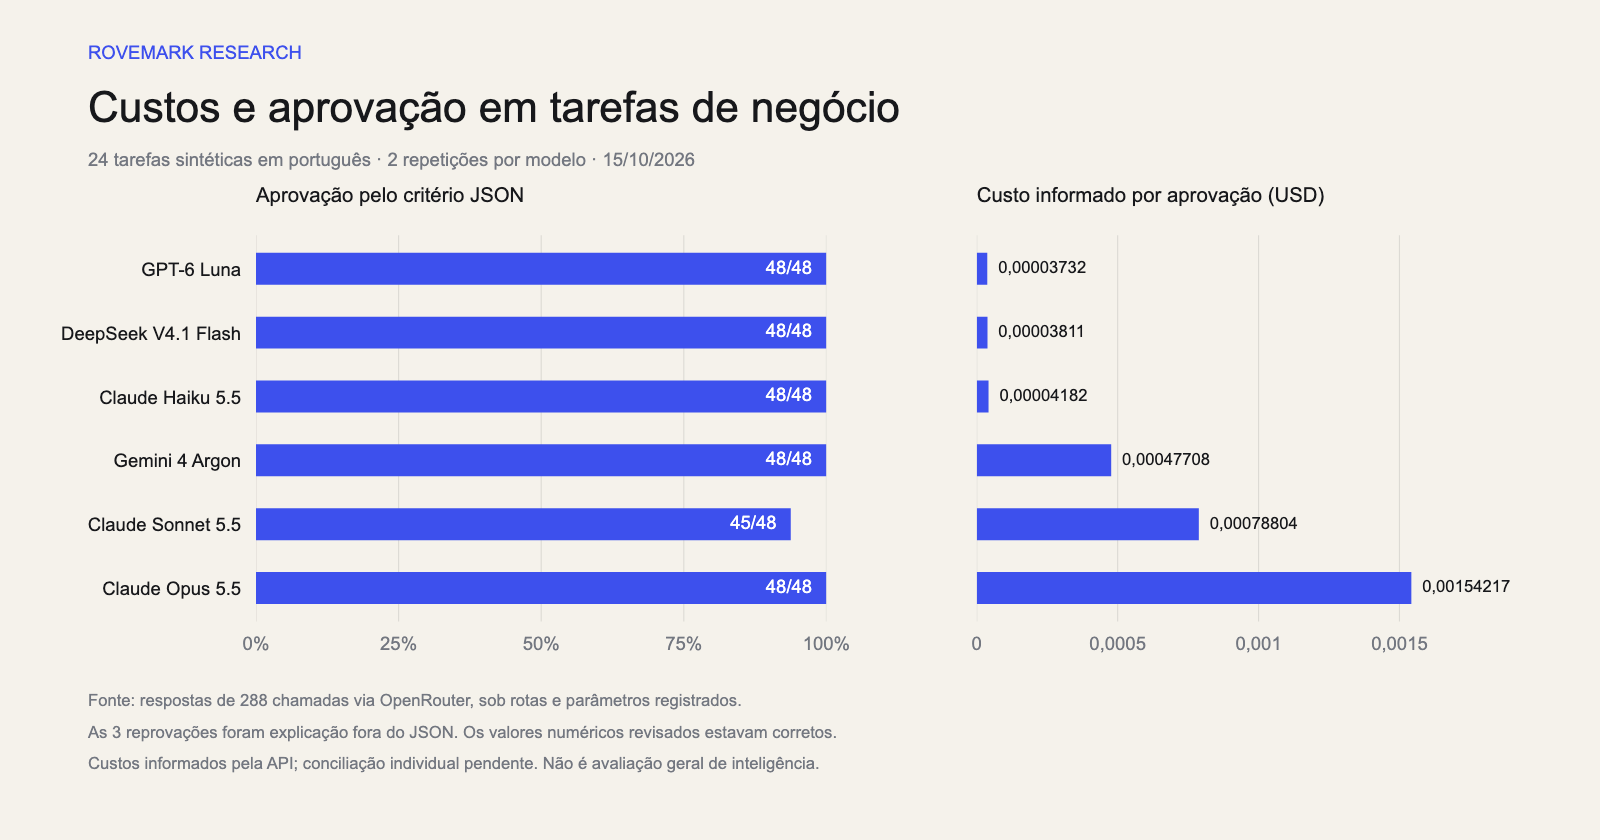
GPT-6 Luna teve o menor custo informado por aprovação nesta amostra, muito próximo do DeepSeek V4.1 Flash. Haiku 5.5 teve a menor mediana de tempo. Cinco modelos cumpriram o critério em 48 de 48 tentativas. As três reprovações do Sonnet 5.5 foram por explicação fora do JSON; os valores numéricos revisados estavam corretos.
Selecione uma barra para inspecionar as respostas daquele modelo abaixo. Nos indicadores de tempo e custo, valores menores são melhores. O tempo inclui a rede e as tentativas com erro; uma falha rápida não demonstra melhor desempenho.
| Modelo | Aprovações | Erros de API | Custo informado | Custo informado por aprovação | Mediana / p95 |
|---|---|---|---|---|---|
| OpenAI: GPT-6 LunaRota solicitada: openai | 48/48100% | 0 | USD 0,0017915 | USD 0,00003732 | 2,01 s / 2,93 s |
| DeepSeek: DeepSeek V4.1 FlashRota solicitada: decart/fp4 | 48/48100% | 0 | USD 0,00182934 | USD 0,00003811 | 2,93 s / 8,99 s |
| Anthropic: Claude Haiku 5.5Rota solicitada: google-vertex/global | 48/48100% | 0 | USD 0,0020076 | USD 0,00004182 | 1,1 s / 2,09 s |
| Google: Gemini 4 ArgonRota solicitada: google-vertex/global | 48/48100% | 0 | USD 0,0229 | USD 0,00047708 | 2,6 s / 3,88 s |
| Anthropic: Claude Sonnet 5.5Rota solicitada: google-vertex/global | 45/4893,8% | 0 | USD 0,035462 | USD 0,00078804 | 1,31 s / 2,64 s |
| Anthropic: Claude Opus 5.5Rota solicitada: amazon-bedrock | 48/48100% | 0 | USD 0,074024 | USD 0,00154217 | 1,62 s / 4,3 s |
Valores de usage.cost informados nas respostas do OpenRouter, em USD. A conciliação externa individual permanece pendente e não foi substituída por uma estimativa de débito. Incluem tentativas incorretas e com falha quando cobradas. Não incluem compra de créditos, impostos, câmbio, infraestrutura ou custo humano de revisão. Quando faltar usage.cost em alguma tentativa, os totais informados ficam indisponíveis. Isso é separado da conciliação externa do extrato, sinalizada acima.
A inspeção usa a seleção de modelo e tarefa abaixo, independente do recorte do gráfico.
As solicitações e respostas originais abaixo estão em português, idioma da execução. A tradução da interface não altera os registros do teste.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.
{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,66 s · temperatura 0
Provedor informado: Decart · rota solicitada: decart/fp4
{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0,00003753 · 2,97 s · temperatura 0
Provedor informado: Decart · rota solicitada: decart/fp4
3 de 288 tentativas não atenderam ao critério. Falhas de transporte, problemas de formato e divergências de conteúdo são identificados separadamente quando observados. As três reprovações desta execução foram texto adicional fora do JSON: uma revisão manual posterior confirmou que os valores numéricos desses casos coincidiam com a referência. Essa revisão não alterou as notas do critério original.
Todos os casos usam informações sintéticas. São quatro grupos: extração, uso de fontes, cálculos de negócio e cumprimento de instruções.
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}O plano definiu duas repetições por tarefa e modelo. Repetir os mesmos casos não cria 48 tarefas independentes. A ordem foi embaralhada com semente registrada, com limite de saída, preço e gasto total. Chamadas pagas enviadas não foram repetidas automaticamente.
A aprovação exata mede um conjunto restrito de tarefas com respostas fechadas. Ela não mede qualidade literária, toda a inteligência de um modelo ou o efeito da IA na produtividade de uma empresa. Não usamos outro modelo como juiz nem ativamos modo JSON ou esquema de resposta do provedor. Avaliamos o atendimento ao formato por instrução no prompt. O uso de saída estruturada pode mudar esse comportamento e não foi testado aqui. A ordem das chaves e uma eventual cerca de código JSON são ignoradas; valores e conjunto de chaves precisam coincidir com a referência.
Os registros identificam modelo, rota solicitada, provedor informado, parâmetros, data e consumo efetivo. Quatro das seis rotas não oferecem ajuste de temperatura: o parâmetro foi omitido nesses casos. Nas outras duas, usamos temperatura zero. Esforço de raciocínio e comportamento padrão podem diferir entre famílias; não presumimos parâmetros equivalentes. O teto de saída foi de 700 tokens em todas as tentativas. Taxas de compra de créditos, impostos, câmbio e infraestrutura ficam fora do custo de inferência e devem ser considerados nas decisões comerciais.
A Rovemark desenvolve produtos com IA e tem interesse comercial nessa tecnologia. O protocolo, os registros sintéticos, o código e os arquivos exatos da execução estão disponíveis para revisão independente. Os casos não foram alterados após o início das chamadas.
Muitos fornecedores publicam preços, características e avaliações dos próprios modelos. Podemos reunir essas informações com fonte e data, sem fazer chamadas pagas. A tabela de preços desta página vem do catálogo público do OpenRouter. Os resultados das 288 chamadas vêm do teste técnico da Rovemark e estão apresentados separadamente. Resultados de terceiros devem ser atribuídos aos autores, sem serem apresentados como validação nossa.
Quando uma decisão concreta depende de algo que as fontes disponíveis não respondem, como o cumprimento de um formato nas nossas instruções ou o custo de um fluxo específico. Primeiro definimos a pergunta e verificamos os estudos existentes. Se ainda faltar evidência, propomos o menor teste adequado, com critérios e orçamento definidos antes da execução. Um teste com tarefas sintéticas não substitui uma pesquisa sobre produtividade nas empresas.
Ele compara seis modelos neste conjunto de 24 tarefas em português, sob as rotas e configurações registradas. Uma taxa maior aqui não prova superioridade geral. Não testamos toda a escrita, o raciocínio aberto ou os fluxos de trabalho possíveis.
O custo observado ajuda a escolher candidatos para tarefas semelhantes. O conjunto não testa chamadas de ferramentas reais, documentos longos, imagens, dados privados ou todos os controles de segurança de um produto. Uma mudança de modelo em produção precisa de avaliação no fluxo em que ele será usado.
Preço por token não informa quantos tokens o modelo vai consumir nem quantas respostas serão aproveitáveis. Dividimos o gasto de todas as tentativas pelo número das que passaram no critério. As respostas erradas também custam e entram no total.
São 24 tarefas, cada uma repetida duas vezes. As repetições ajudam a observar variação, mas não ampliam a diversidade para 48 problemas independentes. Os resultados são descritivos; não publicamos intervalos de confiança ou significância estatística para uma população de tarefas.
Na consulta aos endpoints, quatro das seis rotas não declararam suporte ao parâmetro temperature. Nelas, omitimos o ajuste e registramos o padrão do provedor. Nas outras duas, usamos zero. O limite de saída foi de 700 tokens para todos. Temperatura e esforço de raciocínio de famílias diferentes não são presumidos equivalentes.
A seção de inspeção mostra a solicitação, a referência e as duas respostas do modelo. A aprovação exige os mesmos valores e chaves no objeto JSON; a ordem das chaves e uma eventual cerca de código JSON são ignoradas. Os dados completos preservam respostas reprovadas e falhas de API.
Os arquivos exatos da execução, o protocolo, as respostas de referência, a semente de ordenação e os resultados estão disponíveis para download. Uma nova execução exige sua própria credencial e orçamento. Disponibilidade, preços e comportamento dos provedores podem mudar, mesmo mantendo o identificador do modelo.
O custo de inferência é apenas uma parte da operação. Taxas, impostos, câmbio, infraestrutura e revisão humana ficam fora deste indicador. O teste não mede produtividade de empresas. O protocolo separado de produção e revisão com empresas continua sem resultados próprios publicados.