现在由模型做选择
它会阅读、总结,并决定哪些品牌适合出现在回答中。没有竞价,没有出价,也无法购买席位。能进入的,是它能根据找到的信息给出依据的品牌。
对于我这个规模的业务,[您的行业]中哪家公司最好?
在旧搜索引擎中,排名下滑、流量下降,总会有人注意到。在 AI 的回答中,没有第二页,也没有排名下滑。只有是否被包含在内。而没有看到你的客户,也不知道你的存在,因此不会去找你。
它会阅读、总结,并决定哪些品牌适合出现在回答中。没有竞价,没有出价,也无法购买席位。能进入的,是它能根据找到的信息给出依据的品牌。
不会有提醒、电子邮件或面板通知你的品牌被排除。回答只是没有你,客户在到达你的网站前,对话就结束了。
同一个问题,在 ChatGPT、Gemini、Perplexity 和 Claude 中会得到不同的品牌。一个表现好,并不代表其他引擎也好,因此必须逐个引擎衡量。
每一轮,模块都会提问、读取完整回答,并保存找到的内容。你早上打开的不是印象,而是 AI 对你的品牌持续在说什么的快照,附有日期和来源。
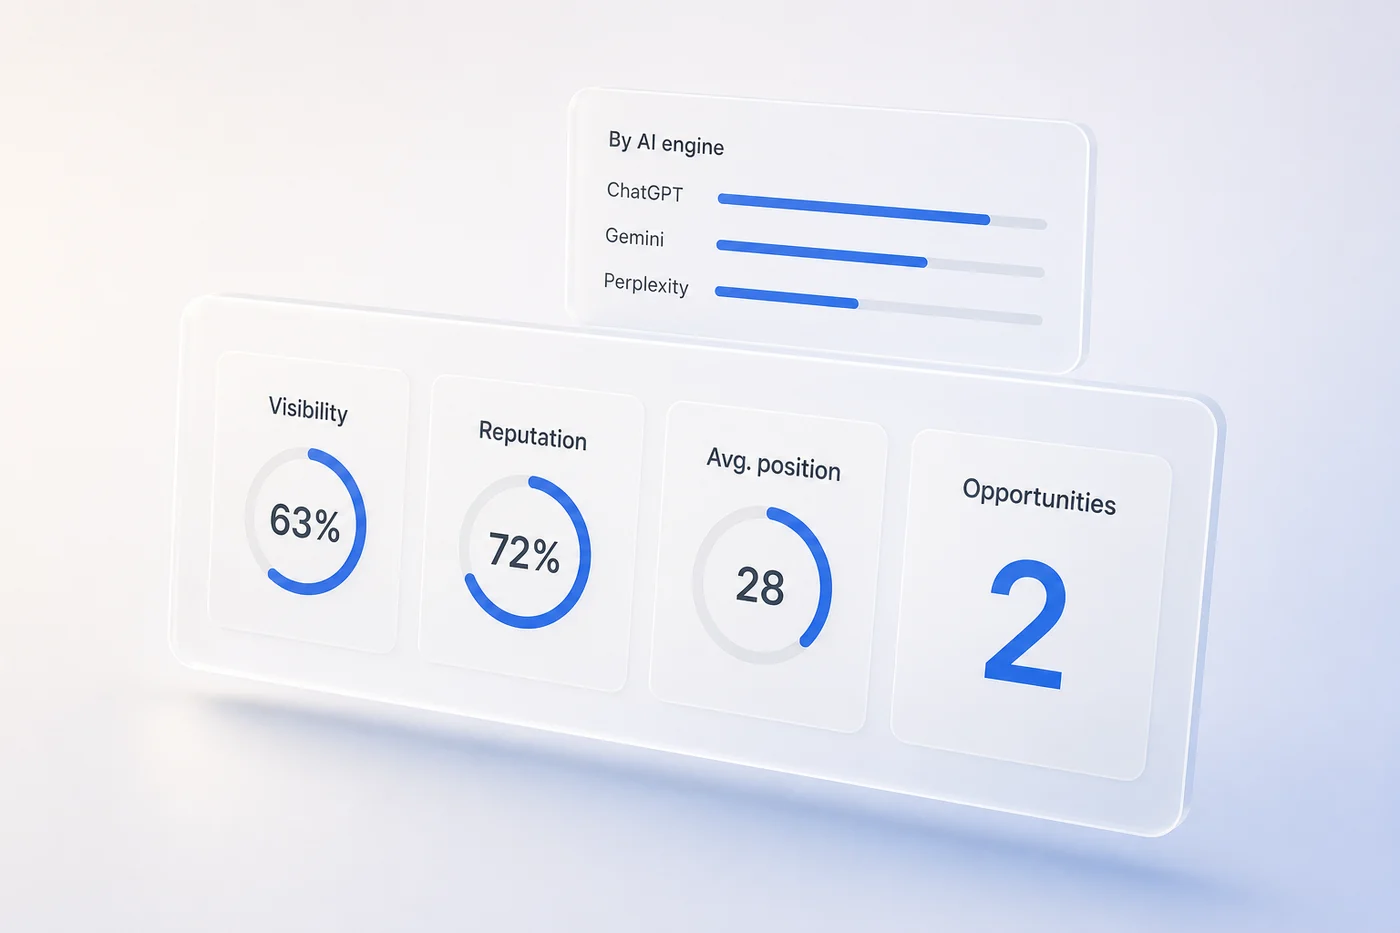
在你的市场每十个问题中,有多少会提到你的品牌。这是概括一切的数字,也是唯一可以逐月跟踪的数字。
被提到还不够,关键在于如何被提到。模块会区分正面提及、保留意见,以及将你列为更贵选项的比较。
你出现在回答的什么位置,以及在被提到品牌所占空间中,你与每个竞争对手相比占多少。
AI 的说法来自哪里,以及你没有出现的问题清单。下一个工作就在这些问题里。
在每个助手中分别进行衡量,问题按客户会写的方式提出。没有掩盖你表现不佳引擎的平均值。
覆盖范围最大,也最常把记忆和搜索混在一起的助手。它引用的品牌不多,而且常常重复。能进入,就能留下。
强烈依赖 Google 已索引的内容,因此会奖励结构清晰、完整回答问题的页面,而不只是标题。
总会直接向用户标明来源。在这个引擎中,最容易看清楚到底是哪个页面让 AI 提到你,或提到竞争对手。
更保守,更倾向于只陈述能支撑的内容。出现在这里通常需要第三方材料,不只是你自己的网站。
Google 在自身搜索中生成的回答。采集器已经存在,正在校准。读取结果验证后,就会向客户开放。
只有采集结果核实后,引擎才会计入。可疑数据不会在这里变成指标。我们宁可清单更小,但内容真实。
即时完成的一次样本测量,覆盖当前可用的引擎。输入网站地址,即可在本页查看结果:知道数字之后,注册才有意义。
填写你的行业,直接带走现成列表。今晚把它粘贴到 ChatGPT,亲眼看看谁被引用:这正是该模块每天在四个引擎中做的事。
[你的行业] 最好的公司是哪家?
巴西主要的 [你的行业] 选择有哪些?
值得聘请 [你的行业] 吗?优点和缺点是什么?
[你的行业]要多少钱,包含什么?
[你的行业]领域有没有更便宜又不降低质量的选择?
比较[你的行业]领域最知名的三家公司。
对于中型企业,哪家[你的行业]公司更合适?
选择[你的行业]服务时需要注意什么?
[你的行业]领域最可靠的公司有哪些?
刚起步的话,[你的行业]领域哪个选择最好?
这些是模板,不是测量结果:用于作为起点。在产品中,问题来自你的市场,以及客户真正会写下的内容。
这些对比都不是在贬低对方: SEO有用,表格有用,图表工具也有它的作用。关键在于每一种止步于哪里。
没有媒体预算的情况下,回答中的自然引用就是渠道。先测量五个问题,针对你没有出现的那两个来写内容。
团队在发布内容,但没人知道那是否变成了引用。这里的内容来自实测出的缺口,下一轮结果会告诉你是否有效。
按产品线和地区逐项跟踪,历史记录可导出,记忆留在公司内部。
这不是抽签,也不是竞价。模型必须为自己说的话找到依据,它会选择能用已掌握信息证明的内容。有四件事比其他都更重要。
媒体、对比文章或论坛里的提及,比你自己的网站更有分量:模型把第三方当作证人,把你当作利益相关方。
当三个不同的地方用同样的方式描述你时,模型就更有信心去断言。每个渠道说法都不一样,会削弱被引用的可能。
标题是问题、下面直接给出答案的文本,比好看的企业介绍页面更容易被引用。
在变化快的领域,模型更偏好当年的内容。一个2019年没更新过的页面,会输给规模更小的竞争对手的新页面。
大多数可见度工具到这里就停了:交付图表后离开。这里,发现的缺口会直接成为任务,任务又会变成已发布的材料,因为下一轮找到的是已发布的材料。
免费衡量我的品牌每一级都对应基于已测得缺口发布的一份内容。图表不会自己上涨:有人写出缺少的内容时,它才会上涨。
模块会显示准确的问题、提出该问题的引擎、代替你被提到的品牌,以及支撑那次引用的页面。
明确需要什么内容、应出现在哪里,以及优先级。出现在三个引擎中的缺口,比只出现在一个引擎中的更重要。
两周后,会重新提出同一个问题。你的品牌要么进入回答,要么没有进入,结果会出现在图表中,而不是会议上。
名称、网站和所在市场。模块据此判断哪些问题有意义。
系统会建议客户会问的问题,你可以删除、添加,并标记两到四个竞争对手进行比较。
第一轮立即出结果。之后会按你选择的频率自动重复。
不再盲目写内容:选题来自品牌未出现的问题,内容效果会在下一轮呈现。
在第一次会议前,了解 AI 正在向客户推荐哪个竞争对手,以及用了什么理由。
了解市场如何描述这个品类,以及你的方案在哪里被误读,无需等到季度调研。
可见度、声誉、位置、来源和机会:可导出。
为什么那个页面没有成为来源,以及它缺少什么。
根据引擎显示的结果制作,用来填补缺口的内容。
不同引擎的网页搜索成本不同,Rovemark 会转交这项差异,而不是按平均价格收费。需要大规模测量的人用 Perplexity,需要 Gemini 回答的人支付其实际成本。选择权在付款人手中。
900 次测量,每次都保存完整回答
免费套餐每月提供 1,000 个积分。在 Perplexity 中相当于 50 次测量,在 Gemini 中相当于 10 次。无需银行卡就能知道自己是否入选,并决定把积分花在哪里。
免费衡量我的品牌不是。SEO 争夺的是链接列表中的位置,用户还会自行选择。这里,模型在任何点击之前就已经做出了选择。被衡量的内容变了,是引用,不是排名。决定者变了,是模型,不是索引。工作也变了,让 AI 引用你的,通常是能够支撑某项主张的材料,不是优化过的标题。SEO 做得好的人会占先机,但这不是同一件事。
由你选择:每小时、每六小时、每天两次、每天或每周。默认是每天一次,足以看到变化,也不会白白消耗积分:AI 的回答不会从早到晚变化,只有有人发布了内容时才会变。
取决于你的余额能支撑多少:按被测量的问题计费,不按已注册品牌计费。实际中,大多数人会跟踪自己的品牌和两到四个竞争对手,因为对比正是让这个数字有意义的原因。
有帮助。代理商可以针对让你落选的确切问题,以及让竞争对手被引用的页面开展工作,而不是靠猜。它发布内容的结果会在下一轮显示,并带有日期。
你的公司在这里积累的内容,会使用你的密钥保存在 Cerne 中:问题、收集到的回答、历史记录。你随时都可以完整导出,它不会成为任何模型的训练数据。
定义足够简短,可以被引用,包括被问到这些内容的 AI。