公開データ
価格と特性はOpenRouterカタログに基づいています。ベンダーや他の研究者がリリースしたベンチマークは、ソースの帰属、バージョン、方法を維持する必要があります。
公開価格を見る技術評価・RVMR-B01
モデルの公開価格と、別途当社の技術テストの結果を参照してください。各情報の出所、日付、制限が特定されています。
モデルの価格と特性は、公開情報源で参照できます。私たちのテストでは、24 合成タスクの測定が追加されています。価格を確認する必要はなく、企業の生産性の向上を測定するものでもありません。
価格と特性はOpenRouterカタログに基づいています。ベンダーや他の研究者がリリースしたベンチマークは、ソースの帰属、バージョン、方法を維持する必要があります。
公開価格を見る合成データを使用した 288 通話で API によって報告された応答、時間、コスト。結果は、登録されたタスクと設定に限定されます。
テスト結果の表示コンテンツの制作およびレビューのプロトコルは登録可能です。企業の業務への影響についてはまだ公表されていない。
研究について調べるまずは利用可能なソースから始めます。特定のテストは、回答できない特定の質問がある場合にのみ提案されます。実行する前に、質問、評価基準、予算を定義します。
相談。これは、自動更新されずにテストで使用されるレジストリです。
通貨換算なしの USD での 100 万トークンあたりのエントリー価格とエグジット価格。ルート列には、フォールバックが無効になっている、テストで要求されたプロバイダーの公示価格が表示されます。 Rovemark が顧客に請求する価格ではありません。キャッシュやリクエストごとの料金などの他のフィールドは、参照されるファイル内にあります。それらはこの入出力表には含まれていません。
| モデルとバージョン | カタログ: 入力/出力 | 要求されたルート: in/out |
|---|---|---|
DeepSeek: DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash-20260910 | USD 0.0173 / 0.8 | USD 0.09 / 0.18decart/fp4 |
OpenAI: GPT-6 Lunaopenai/gpt-6-luna-20260922 | USD 0.1 / 0.5 | USD 0.1 / 0.5openai |
Anthropic: Claude Haiku 5.5anthropic/claude-haiku-5.5-20261007 | USD 0.1 / 0.5 | USD 0.1 / 0.5google-vertex/global |
Google: Gemini 4 Argongoogle/gemini-4-argon-20261013 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Sonnet 5.5anthropic/claude-sonnet-5.5-20260928 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Opus 5.5anthropic/claude-opus-5.5-20260921 | USD 4 / 20 | USD 4 / 20amazon-bedrock |
検索を選択しても、Rovemark モデルや料金表は変更されません。プランは実行前にプロバイダーと価格制限を修正し、ルーティング設定でデータ収集をブロックしました。
24 の各タスクには検証可能なリファレンスがあります。評価では、受信した JSON と、欠損値や承認なしのアクションの実行の拒否など、予期される応答が比較されます。
不正な試行を含むすべての試行のコストは、承認された試行のコストで分割されます。承認がない場合、または試行中に usage.cost が欠落している場合、承認ごとに報告されるコストは計算されません。
当社は、顧客が観察した時間の中央値と 95 パーセンタイル、およびエラーと無効な応答を公開します。時間にはネットワークが含まれ、プロバイダーと日付によって異なります。
同じ合成タスク 24、モデルごとに 2 回繰り返します。料金はパラメータと登録プロバイダーの下にポルトガル語でこのセットを説明します。承認には正しい JSON 値と形式が必要です。これは、個別の事実の正確率ではありません。このテストは、企業の生産性や各モデルの最大能力を測定するものではありません。
API 応答によって報告されるコスト。パネル上のコール数の集計検証も含まれます。調整後の個別の料金は提示しません。違いを調査するために新たな推論は行われませんでした。
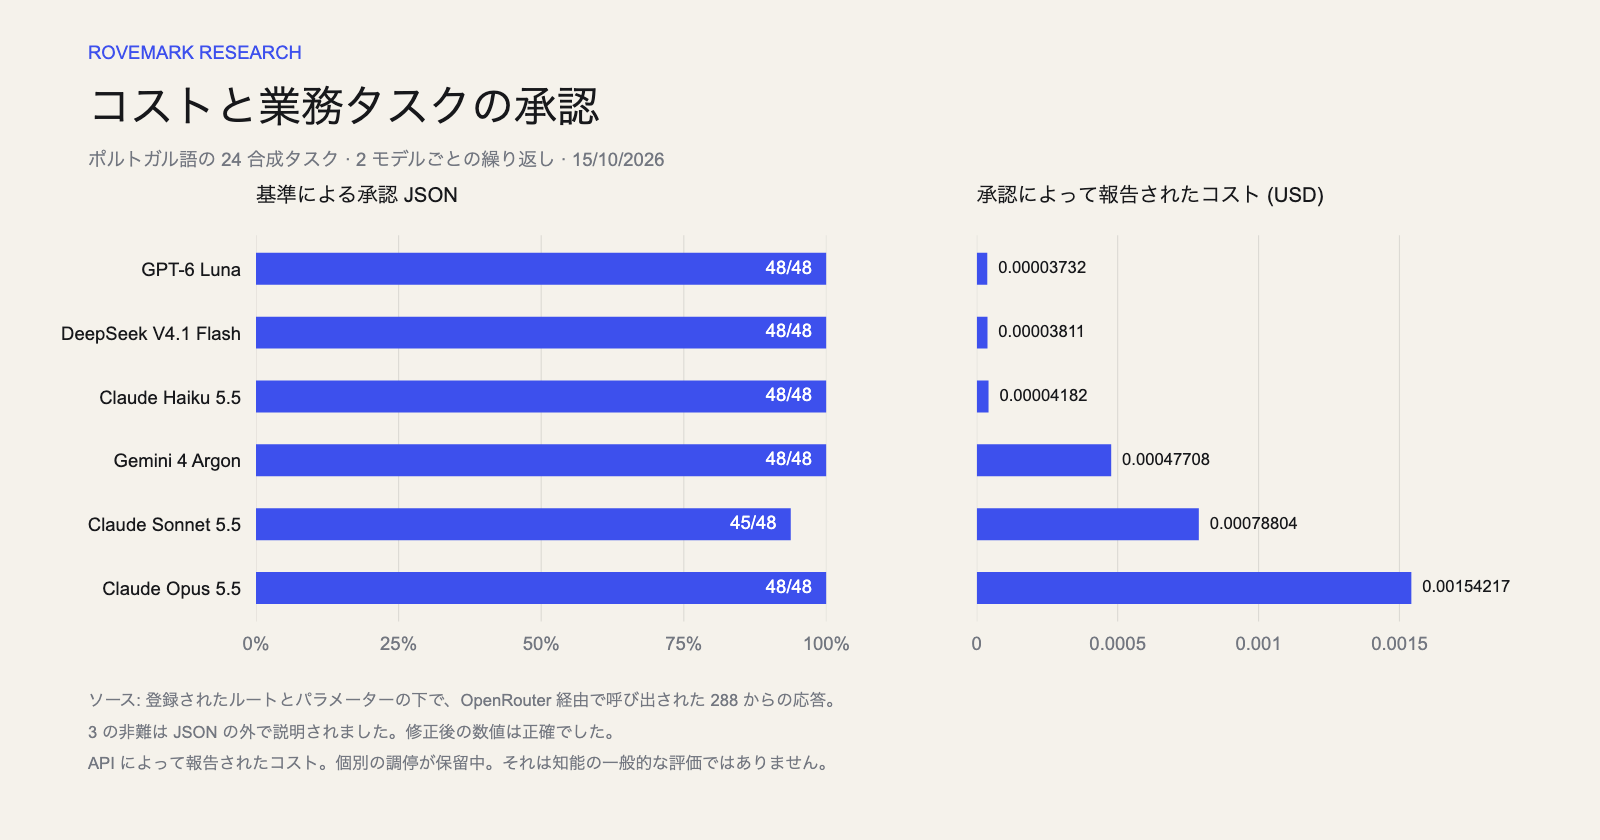
GPT-6 Luna は、このサンプルで報告された承認あたりのコストが最も低く、DeepSeek V4.1 Flash に非常に近かったです。 Haiku 5.5 の中央時間は最も短かったです。 5 つのモデルが 48 試験の 48 の基準を満たしました。 Sonnet 5.5 に対する 3 つの不承認は、JSON の外部での説明によるものでした。修正された数値は正しかったです。
バーを選択して、以下のモデルの応答を調べます。時間とコストの指標では、値が低いほど優れています。時間にはネットワークとエラーのトライアルが含まれます。すぐに失敗してもパフォーマンスが向上するわけではありません。
| モデル | 承認 | API エラー | 報告コスト | 承認により報告されるコスト | 中央値 / p95 |
|---|---|---|---|---|---|
| OpenAI: GPT-6 Lunaリクエストされたルート: openai | 48/48100% | 0 | USD 0.0017915 | USD 0.00003732 | 2.01s / 2.93s |
| DeepSeek: DeepSeek V4.1 Flashリクエストされたルート: decart/fp4 | 48/48100% | 0 | USD 0.00182934 | USD 0.00003811 | 2.93s / 8.99s |
| Anthropic: Claude Haiku 5.5リクエストされたルート: google-vertex/global | 48/48100% | 0 | USD 0.0020076 | USD 0.00004182 | 1.1s / 2.09s |
| Google: Gemini 4 Argonリクエストされたルート: google-vertex/global | 48/48100% | 0 | USD 0.0229 | USD 0.00047708 | 2.6s / 3.88s |
| Anthropic: Claude Sonnet 5.5リクエストされたルート: google-vertex/global | 45/4893.8% | 0 | USD 0.035462 | USD 0.00078804 | 1.31s / 2.64s |
| Anthropic: Claude Opus 5.5リクエストされたルート: amazon-bedrock | 48/48100% | 0 | USD 0.074024 | USD 0.00154217 | 1.62s / 4.3s |
usage.cost 値は、OpenRouter 応答、USD で報告されます。個別の対外調整は保留中であり、債務見積りに置き換えられていない。これには、課金時の誤った試行や失敗した試行も含まれます。これらには、クレジットの購入、税金、為替レート、インフラストラクチャ、レビューの人件費は含まれません。いずれかの試行で usage.cost が欠落している場合、報告された合計は使用できなくなります。これは、上でフラグを立てたステートメントの外部調整とは別のものです。
インスペクションでは、チャートのクリッピングに関係なく、以下のモデルとタスクの選択が使用されます。
以下の元のリクエストとレスポンスは、実行言語であるポルトガル語で書かれています。インターフェースの変換によってテスト記録は変更されません。
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.
{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0.00003753 · 2.66s 温度 0
プロバイダーは次のように通知しました。 Decart · リクエストされたルート: decart/fp4
{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0.00003753 · 2.97s 温度 0
プロバイダーは次のように通知しました。 Decart · リクエストされたルート: decart/fp4
3 の 288 試行は基準を満たしていませんでした。転送エラー、フォーマットの問題、およびコンテンツの不一致は、指摘された場合には個別に特定されます。この実行の 3 つの失敗は、JSON 以外の追加テキストでした。後の手動レビューにより、これらのケースの数値が参照と一致することが確認されました。このレビューでは、元の基準スコアは変更されませんでした。
すべてのケースでは合成情報が使用されます。抽出、ソースの使用、ビジネス計算、および指示に従うという 4 つのグループがあります。
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}この計画では、タスクとモデルごとに 2 つの繰り返しが定義されました。同じケースを繰り返しても、48 の独立したタスクは作成されません。注文は登録済みのシード、終了制限、価格、総支出でシャッフルされました。送信された有料通話は自動的に再試行されませんでした。
正確なパスは、クローズドな応答を持つ狭いタスクのセットを測定します。文学的な品質、モデルの完全なインテリジェンス、または企業の生産性に対する AI の影響を測定するものではありません。他のモデルをジャッジとして使用したり、JSON モードやプロバイダー応答スキームをアクティブにしたりすることはありません。プロンプトの指示ごとに形式への準拠を評価します。構造化された出力を使用すると、この動作が変わる可能性がありますが、ここではテストされていません。キーの順序と考えられるコード フェンス JSON は無視されます。値とキーセットは参照と一致する必要があります。
記録により、モデル、要求されたルート、通知されたプロバイダー、パラメータ、日付、および実際の消費量が特定されます。 6 つのルートのうち 4 つは温度調整を提供していません。これらの場合、パラメータは省略されています。他の 2 つでは、ゼロ温度を使用します。推論の努力や標準的な行動は家族によって異なる場合があります。同等のパラメータは想定しません。出力上限はすべての試行で 700 トークンでした。クレジット購入率、税金、為替レート、インフラストラクチャは推論コストの範囲外であり、商業上の決定において考慮する必要があります。
Rovemark は AI 製品を開発しており、このテクノロジーに商業的関心を持っています。プロトコル、合成レコード、コード、および正確な実行ファイルは、独立したレビューに利用できます。通話開始後も事件は変更されなかった。
多くのサプライヤーは、自社モデルの価格、機能、レビューを公開しています。有料通話を行わなくても、この情報をソースと日付とともに収集できます。このページの価格表は OpenRouter 公開カタログからのものです。 288 呼び出しの結果は、Rovemark の技術テストから得られたものであり、別個に示されています。第三者による結果は、当社による検証として提示されることなく、著者に帰属するものでなければなりません。
具体的な決定が、当社の指示にある形式への準拠や特定のフローのコストなど、利用可能な情報源では答えられていないものに依存する場合。まず質問を定義し、既存の研究を確認します。それでも証拠が不足している場合は、実行前に基準と予算を定義して、最小限の適切なテストを提案します。合成タスクを使用したテストは、企業の生産性に関する研究に代わるものではありません。
登録されたルートと構成に基づいて、ポルトガル語の 24 タスク セットの 6 つのモデルを比較します。ここでのレートが高いことは、全体的な優位性を証明するものではありません。私たちは、考えられるすべての文章、自由な発想、ワークフローをテストするわけではありません。
観察されたコストは、同様のタスクの候補を選択するのに役立ちます。このスイートでは、実際のツール呼び出し、長いドキュメント、画像、プライベート データ、または製品のセキュリティ制御のすべてはテストされません。生産におけるモデルチェンジには、どのようなフローで使用されるかを評価する必要があります。
トークンあたりの価格からは、モデルが消費するトークンの数や使用可能な応答の数はわかりません。すべての試行の費用を基準に合格した試行の数で割ります。不正解も費用がかかり、合計に含まれます。
これらは 24 タスクであり、それぞれ 2 回繰り返されます。繰り返しは変動を観察するのに役立ちますが、多様性を 48 の独立した問題に拡張することはできません。結果は説明的です。タスクの母集団に対する信頼区間や統計的有意性は公表しません。
エンドポイントをクエリすると、6 つのルートのうち 4 つが temperature パラメーターのサポートを宣言していませんでした。それらでは、調整を省略し、プロバイダーのデフォルトを記録します。他の 2 つはゼロを使用します。終了制限は全員の 700 トークンでした。異なる家族の温度と推論努力が同等であるとは想定されていません。
検査セクションには、モデルのリクエスト、参照、および 2 つの応答が表示されます。承認には、JSON オブジェクト内の同じ値とキーが必要です。キーの順序と考えられるコード フェンス JSON は無視されます。完全なデータには、失敗した応答と API 失敗が保存されます。
正確な実行ファイル、プロトコル、参照応答、ソート シード、および結果をダウンロードできます。新しい実行には独自の認証情報と予算が必要です。モデル識別子が維持されている場合でも、可用性、価格設定、プロバイダーの動作は変更される場合があります。
推論コストは操作の一部にすぎません。手数料、税金、為替レート、インフラストラクチャ、人間によるレビューはこの指標から除外されます。このテストは企業の生産性を測定するものではありません。企業との個別の作成およびレビュープロトコルは、独自の結果が公表されることなく継続されています。