公开数据
价格和特性参见 OpenRouter 目录。供应商或其他研究人员发布的基准必须维护来源归属、版本和方法。
查看公布的价格技术评测·RVMR-B01
请参阅型号的公开价格以及我们的技术测试结果。每个信息的来源、日期和限制均已明确。
模型的价格和特性可以在公共资源中查阅。我们的测试增加了对 24 综合任务的测量;没有必要咨询价格,也不衡量公司生产率的提高。
价格和特性参见 OpenRouter 目录。供应商或其他研究人员发布的基准必须维护来源归属、版本和方法。
查看公布的价格API 在 288 调用中使用合成数据报告的响应、时间和成本。结果仅限于已注册的任务和设置。
查看测试结果内容制作和审查协议开放注册。关于对公司工作的影响,目前还没有公布结果。
了解该研究我们从可用的来源开始。仅当存在他们未回答的特定问题时才会提出特定测试。在执行之前,我们定义问题、评估标准和预算。
咨询。这是测试时使用的注册表,没有自动更新。
USD 中每百万代币的入场和出场价格,无需货币转换。路线列显示测试中请求的提供商的广告价格,并禁用回退。这不是Rovemark向客户收取的价格。其他字段,例如缓存和每个请求的费用,都在查阅的文件中;它们不包含在此输入和输出表中。
| 型号及版本 | 目录:输入/输出 | 请求路线:进/出 |
|---|---|---|
DeepSeek: DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash-20260910 | USD 0.0173 / 0.8 | USD 0.09 / 0.18decart/fp4 |
OpenAI: GPT-6 Lunaopenai/gpt-6-luna-20260922 | USD 0.1 / 0.5 | USD 0.1 / 0.5openai |
Anthropic: Claude Haiku 5.5anthropic/claude-haiku-5.5-20261007 | USD 0.1 / 0.5 | USD 0.1 / 0.5google-vertex/global |
Google: Gemini 4 Argongoogle/gemini-4-argon-20261013 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Sonnet 5.5anthropic/claude-sonnet-5.5-20260928 | USD 2 / 10 | USD 2 / 10google-vertex/global |
Anthropic: Claude Opus 5.5anthropic/claude-opus-5.5-20260921 | USD 4 / 20 | USD 4 / 20amazon-bedrock |
搜索选择不会更改 Rovemark 型号或计费表。该计划在执行前固定了供应商和价格限制,并阻止路由偏好中的数据收集。
每个 24 任务都有一个可验证的参考。评估将收到的JSON与预期响应进行比较,包括缺失值和拒绝执行未经授权的操作。
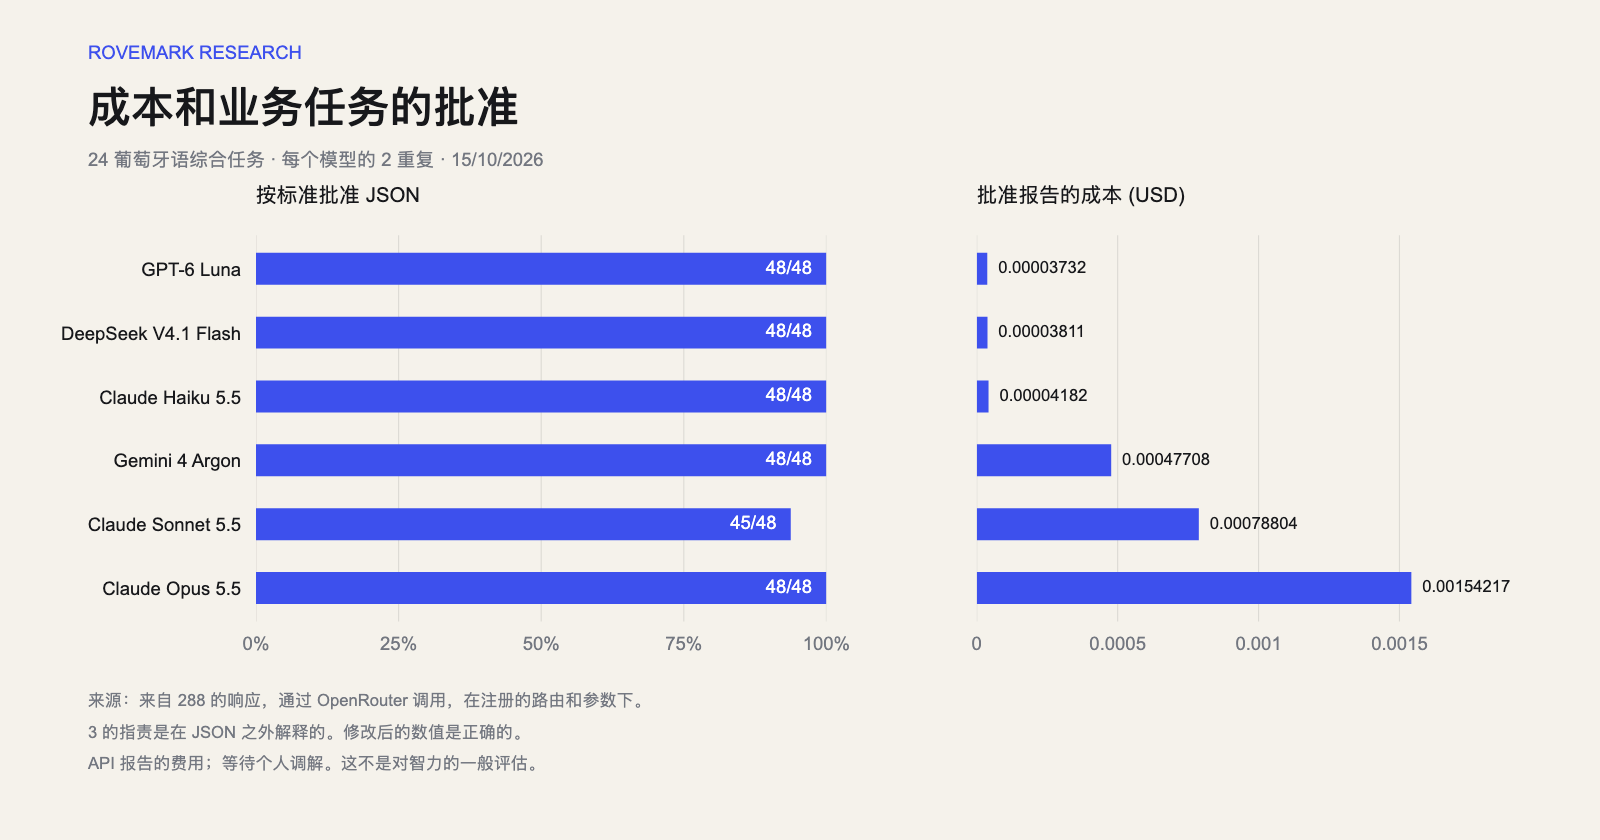
所有尝试(包括错误尝试)的成本除以已批准的尝试的成本。未经批准或在任何尝试中缺少 usage.cost,我们不会计算每次批准报告的成本。
我们发布客户观察到的时间中位数和 95 百分位数,以及错误和无效响应。时间包括网络,取决于提供商和日期。
相同的合成任务 24,每个模型重复两次。费率在参数和注册提供商下以葡萄牙语描述了该组。批准需要正确的JSON值和格式;它不是一个孤立的事实准确率。该测试并不衡量公司的生产力或每种型号的全部容量。
API 响应报告的成本,并汇总验证面板上的呼叫数量。我们不提供已调节的个人费用。没有做出新的推论来调查差异。
在该示例中,GPT-6 Luna 报告的每次批准成本最低,非常接近 DeepSeek V4.1 Flash。 Haiku 5.5 的中位时间最短。有五个模型符合 48 和 48 试验的标准。 Sonnet 5.5的三次不认可是因为JSON之外的解释;修改后的数值是正确的。
选择一个栏来检查下面该模型的响应。在时间和成本指标上,数值越低越好。时间包括网络和错误试验;快速失败并不能表现出更好的性能。
| 型号 | 批准 | API 错误 | 报告成本 | 经批准报告的费用 | 中位数 / p95 |
|---|---|---|---|---|---|
| OpenAI: GPT-6 Luna请求路线: openai | 48/48100% | 0 | USD 0.0017915 | USD 0.00003732 | 2.01s / 2.93s |
| DeepSeek: DeepSeek V4.1 Flash请求路线: decart/fp4 | 48/48100% | 0 | USD 0.00182934 | USD 0.00003811 | 2.93s / 8.99s |
| Anthropic: Claude Haiku 5.5请求路线: google-vertex/global | 48/48100% | 0 | USD 0.0020076 | USD 0.00004182 | 1.1s / 2.09s |
| Google: Gemini 4 Argon请求路线: google-vertex/global | 48/48100% | 0 | USD 0.0229 | USD 0.00047708 | 2.6s / 3.88s |
| Anthropic: Claude Sonnet 5.5请求路线: google-vertex/global | 45/4893.8% | 0 | USD 0.035462 | USD 0.00078804 | 1.31s / 2.64s |
| Anthropic: Claude Opus 5.5请求路线: amazon-bedrock | 48/48100% | 0 | USD 0.074024 | USD 0.00154217 | 1.62s / 4.3s |
usage.cost 值在 OpenRouter 响应中报告,在 USD 中。个别外部调节仍悬而未决,尚未被债务估算取代。包括充电时不正确和失败的尝试。它们不包括购买信贷、税收、汇率、基础设施或人力审查成本。当 usage.cost 在任何尝试中丢失时,报告的总数将变得不可用。这与上面标记的报表的外部调节是分开的。
检查使用下面的模型和任务选择,无论图表裁剪如何。
下面的原始请求和响应是执行语言葡萄牙语。接口翻译不会改变测试记录。
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.
{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0.00003753 · 2.66s 温度 0
提供者告知: Decart · 请求路线: decart/fp4
{"company":"Empresa Sol","total_cents":124990,"due":"2026-11-15"}USD 0.00003753 · 2.97s 温度 0
提供者告知: Decart · 请求路线: decart/fp4
3 的 288 尝试未达到标准。传输故障、格式问题和内容差异在注明时会单独识别。本次运行的三个失败是 JSON 之外的附加文本:后来的手动审查确认这些情况下的数值与参考相匹配。本次审查并没有改变原来的评分标准。
所有案例都使用综合信息。有四组:提取、来源使用、业务计算和遵循指令。
Extraia da nota: Empresa Sol, total R$ 1.249,90, vencimento 15/11/2026. Retorne {"company":string,"total_cents":number,"due":AAAA-MM-DD}.
Responda somente com o objeto JSON pedido. Não acrescente chaves, explicações ou markdown.{
"company": "Empresa Sol",
"total_cents": 124990,
"due": "2026-11-15"
}该计划为每个任务和模型定义了两次重复。重复相同的情况不会创建 48 独立任务。该订单是通过注册种子、退出限制、价格和总支出进行洗牌的。发送的付费电话不会自动重试。
精确通过衡量一组具有封闭响应的狭窄任务。它不衡量文学质量、模型的全部智能或人工智能对公司生产力的影响。我们不使用其他模型作为判断或激活 JSON 模式或提供者响应方案。我们评估是否符合提示中每条指令的格式。使用结构化输出可能会改变此行为,并且尚未在此处进行测试。键的顺序和任何可能的代码围栏 JSON 都被忽略;值和键集必须与引用匹配。
这些记录标识型号、请求的路线、通知的提供商、参数、日期和实际消耗量。六条路线中的四条不提供温度调节:在这些情况下该参数已被省略。在另外两个中,我们使用零温度。家庭之间的推理努力和标准行为可能有所不同;我们不假设等效参数。所有尝试的输出上限均为 700 代币。信贷购买率、税收、汇率和基础设施不在推理成本之内,在商业决策中必须予以考虑。
Rovemark 开发人工智能产品,并对这项技术拥有商业利益。方案、合成记录、代码和精确运行文件可供独立审查。通话开始后,案件没有改变。
许多供应商都会公布自己型号的价格、功能和评论。我们可以收集这些信息的来源和日期,而无需拨打付费电话。本页价格表来自OpenRouter公共目录。 288 调用的结果来自 Rovemark 的技术测试,并单独呈现。第三方结果必须归属于作者,不得作为我们的验证。
当具体决策取决于可用来源无法回答的问题时,例如遵守我们说明中的格式或特定流程的成本。我们首先定义问题并检查现有研究。如果仍然缺乏证据,我们会提出最小的适当测试,并在执行前定义标准和预算。综合任务测试并不能取代对公司生产力的研究。
它在注册的路线和配置下比较了这组 24 葡萄牙语任务中的六个模型。这里较高的比率并不能证明整体优越性。我们不会测试所有可能的写作、开放式思维或工作流程。
观察到的成本有助于选择执行类似任务的候选人。该套件不会测试实际的工具调用、长文档、图像、私有数据或产品的所有安全控制。生产中的模型变更需要对其使用流程进行评估。
每个代币的价格并不表明模型将消耗多少代币,也不表明有多少响应可用。我们将所有尝试的费用除以通过标准的尝试次数。错误的答案也会产生费用并包含在总数中。
有 24 任务,每个任务重复两次。重复有助于观察变化,但不会将多样性扩展到 48 独立问题。结果是描述性的;我们不会发布一组任务的置信区间或统计显着性。
查询端点时,六个路由中有四个未声明对 temperature 参数的支持。在其中,我们省略了调整并记录了提供商的默认值。在另外两个中,我们使用零。每个人的退出限额为 700 代币。不同家庭的温度和推理能力不被假定为相等。
检查部分显示模型的请求、参考和两个响应。批准需要JSON对象中相同的值和键;键的顺序和任何可能的代码围栏 JSON 都将被忽略。完整的数据保留失败的响应和 API 失败。
确切的运行文件、协议、参考响应、排序种子和结果可供下载。新的运行需要自己的凭据和预算。即使在维护型号标识符的情况下,可用性、定价和提供商行为也可能会发生变化。
推理成本只是操作的一部分。该指标不包括费用、税收、汇率、基础设施和人工审核。该测试并不衡量公司的生产力。与公司的单独生产和审查协议仍在继续,但没有发布自己的结果。